Bagaimana AI Mengenali Corak?
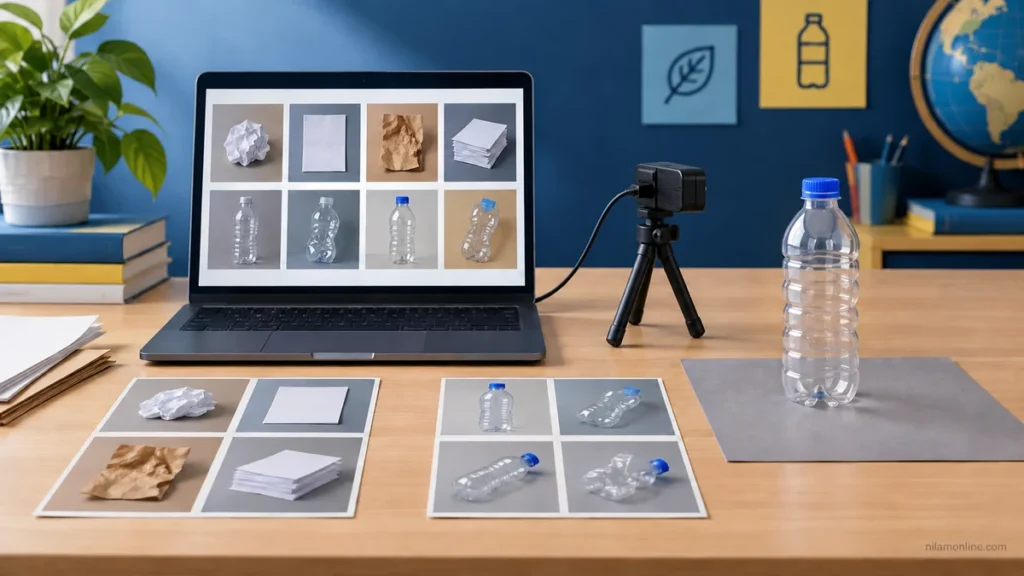
Kredit imej: NilamOnline / Edura Creative — ilustrasi dijana dengan AI — gambaran ilustratif, bukan rajah teknikal berskala atau demonstrasi sistem sebenar
Sebuah kamera menghala ke atas meja. Di hadapannya ada botol plastik kosong. Beberapa saat kemudian, skrin memaparkan perkataan “plastik”. Adakah komputer itu memahami bahan tersebut seperti seorang manusia yang pernah memegangnya?
Dalam sistem pengecaman imej, jawapan biasanya terhasil melalui pengiraan berdasarkan corak yang dipelajari daripada data. Komputer tidak perlu mempunyai pengalaman hidup atau niat untuk menghasilkan ramalan yang berguna. Namun, ramalan itu masih boleh salah.
Mari bayangkan sebuah kelab sekolah membina prototaip pengelasan gambar bahan kitar semula. Projek rekaan ini akan membantu kita mengikuti perjalanan daripada data kepada keputusan, termasuk beberapa masalah yang mungkin tersembunyi di sebalik keputusan yang kelihatan tepat.
Bermula dengan tugas yang jelas
Kecerdasan buatan, atau AI, merangkumi pelbagai pendekatan untuk melaksanakan tugas. Salah satunya ialah pembelajaran mesin, iaitu kaedah membina model daripada data. Model ialah susunan pengiraan dengan parameter yang boleh dilaraskan semasa latihan.
Kelab itu tidak menetapkan matlamat umum seperti “komputer mesti memahami semua sampah”. Mereka memilih tugas lebih kecil: mengelaskan gambar satu objek kepada kategori kertas atau plastik. Mereka juga menetapkan syarat bahawa objek mesti jelas dan berada dalam kawasan kamera.
Had ini penting. Gambar yang mengandungi botol, kotak dan tangan serentak bukan contoh yang sama dengan gambar satu objek. Sistem yang dibina untuk dua kategori juga belum tentu mampu mengenal pasti kaca atau logam.
Tugas yang jelas membantu manusia menentukan data yang diperlukan dan cara menilai hasil. Ia juga mengelakkan demonstrasi kecil dipersembahkan seolah-olah sudah menyelesaikan keseluruhan masalah pengasingan bahan kitar semula.
Data ialah contoh, bukan jawapan ajaib
Ahli kelab mengumpulkan gambar objek yang dibenarkan untuk projek. Setiap gambar diberikan label yang telah diperiksa, misalnya “kertas” atau “plastik”. Dalam pembelajaran diselia, contoh bersama label digunakan untuk melatih model.
Mereka perlu memikirkan kepelbagaian contoh. Kertas mungkin putih, berwarna, rata atau renyuk. Botol plastik pula boleh jernih atau berwarna. Jika semua gambar latihan diambil dengan cara yang terlalu seragam, model mungkin menghadapi kesukaran dalam keadaan lain.
Lebih banyak data tidak secara automatik bermaksud data itu lebih baik. Seribu salinan gambar yang sama tidak memberikan kepelbagaian seperti gambar objek berlainan. Label yang tersalah juga boleh mengarahkan latihan kepada hubungan yang tidak dikehendaki.
Sebelum latihan bermula, kelab menyemak label, membuang pendua dan mencatat batas koleksi. Mereka tidak mengambil gambar wajah atau dokumen peribadi untuk projek ini. Objek serta latar yang ringkas sudah memadai untuk tujuan pembelajaran mereka.
Daripada gambar kepada nombor
Komputer mewakili gambar melalui nilai angka, termasuk nilai warna pada piksel. Piksel ialah unsur kecil yang membentuk imej digital. Corak dalam susunan nilai itu boleh berkait dengan tepi, tekstur atau bentuk objek.
Dalam sesetengah kaedah, manusia menentukan ciri yang hendak diukur. Dalam rangkaian neural, beberapa lapisan pengiraan boleh mempelajari perwakilan yang berguna daripada data. Lapisan awal dan lapisan seterusnya mengubah input secara berperingkat untuk menghasilkan output.
Nama “neural” tidak bermaksud sistem itu mempunyai otak manusia. Ia merujuk kepada bentuk model pengiraan yang diinspirasikan secara umum oleh idea rangkaian unit. Keterangan seperti “model belajar” ialah cara ringkas menerangkan perubahan parameter, bukannya bukti bahawa model mempunyai perasaan.
Untuk prototaip kelab, gambar yang dimasukkan mesti diproses secara konsisten. Jika saiz dan cara menukar nilai gambar berbeza antara latihan dengan penggunaan, hasilnya boleh terjejas walaupun objek masih sama.
Apa berlaku semasa latihan?
Pada permulaan latihan, ramalan model mungkin lemah. Sistem membandingkan output dengan label contoh menggunakan ukuran yang dipanggil fungsi kehilangan, atau loss. Ukuran ini menunjukkan sejauh mana output menyimpang daripada sasaran mengikut peraturan pengiraan yang dipilih.
Kaedah pengoptimuman kemudian melaraskan parameter untuk mengurangkan kehilangan. Salah satu kaedahnya ialah penurunan kecerunan, yang menggunakan arah perubahan dalam pengiraan untuk menentukan pelarasan kecil. Proses ramalan, pengukuran dan pelarasan diulang sepanjang latihan.
Bayangkan banyak tombol nombor dalam satu alat pengiraan. Latihan melaraskan tombol-tombol itu supaya gabungannya memberikan output yang lebih sesuai untuk contoh latihan. Analogi ini membantu, tetapi model sebenar menggunakan operasi matematik, bukannya tangan yang memusing tombol.
Latihan juga tidak menjamin keputusan sempurna. Pilihan model, data dan tetapan latihan mempengaruhi hasil. Kejayaan pada contoh latihan sahaja belum menunjukkan bahawa model akan berfungsi dengan baik pada gambar baharu.
Ujian yang tidak memberi jawapan awal
Kelab memisahkan data kepada set latihan, pengesahan dan ujian. Set latihan digunakan untuk melaraskan parameter. Set pengesahan membantu mereka membandingkan pilihan model atau tetapan. Set ujian disimpan untuk penilaian akhir selepas pilihan tersebut dibuat.
Jika gambar yang sama berada dalam latihan dan ujian, keputusan boleh kelihatan terlalu baik. Begitu juga jika beberapa salinan yang hampir sama tersebar antara set. Kelab perlu memastikan ujian memberikan cabaran yang benar-benar baharu dan relevan.
Model yang terlalu menyesuaikan diri dengan butiran khusus data latihan mungkin gagal pada contoh baharu. Masalah ini dipanggil terlebih suai, atau overfitting. Model yang dapat menggunakan corak berguna pada data baharu pula menunjukkan pengitlakan yang lebih baik.
Ahli kelab mencuba gambar objek lain yang belum digunakan semasa latihan. Mereka turut mencatat keadaan apabila model gagal. Senarai kesilapan itu lebih berguna daripada memilih beberapa contoh berjaya sahaja untuk ditunjukkan kepada guru.
Corak yang salah pun boleh dipelajari
Katakan semua kertas dalam koleksi awal diletakkan di atas alas biru. Semua plastik pula diletakkan di atas alas kuning. Model mungkin menggunakan warna alas sebagai petunjuk kerana petunjuk itu berkait rapat dengan label dalam data latihan.
Apabila botol plastik diletakkan di atas alas biru, sistem mungkin menjawab “kertas”. Komputer tidak sengaja mempermainkan pengguna. Ia menggunakan hubungan yang kelihatan berguna semasa latihan, tetapi hubungan itu tidak sesuai untuk tujuan sebenar.
Kelab membaiki koleksi dengan mempelbagaikan latar bagi kedua-dua kategori. Mereka kemudian menguji semula menggunakan susunan penilaian yang sesuai. Membetulkan data boleh menjadi sama penting dengan menukar model yang digunakan.
Dalam aplikasi yang melibatkan manusia, data yang tidak mewakili kumpulan pengguna juga boleh menghasilkan prestasi tidak seimbang. Oleh itu, purata ketepatan sahaja tidak mencukupi. Penilai perlu memeriksa siapa atau keadaan mana yang paling kerap mengalami kesilapan.
Output masih perlu ditafsir
Sesetengah pengelas menghasilkan skor yang digunakan untuk memilih kategori. Skor tinggi menunjukkan kecenderungan ramalan model mengikut cara model itu dibina. Ia bukan jaminan bahawa objek sebenar telah dikenal pasti dengan betul.
Sebuah sistem juga memerlukan peraturan tindakan. Jika gambar kabur atau di luar skop, pengguna mungkin perlu mengambil gambar semula atau meminta semakan manusia. Memaparkan satu jawapan dengan yakin dalam semua keadaan boleh menyembunyikan batas model.
Selepas prototaip siap, kelab tetap memeriksa hasil sebelum meletakkan objek ke dalam bekas yang sesuai. Mereka tahu gambar sahaja mungkin tidak memberitahu semua perkara, seperti bahan campuran atau keadaan objek. Alat itu membantu satu tugas terhad dalam demonstrasi.
Tiga soalan sebelum mempercayai hasil
Pertama, apakah data yang digunakan? Kedua, bagaimanakah model diuji pada contoh baharu? Ketiga, apakah yang dilakukan apabila model tersilap? Soalan-soalan ini membantu kita menilai sistem dengan lebih teliti daripada hanya melihat satu demonstrasi yang lancar.
Pengecaman corak menjadi berguna apabila tujuan, data, latihan dan penilaian saling sesuai. Manusia tetap menentukan kegunaan dan tindakan selepas menerima output. Memahami proses ini membolehkan kita menggunakan AI dengan lebih cermat, sambil mengenal pasti perkara yang masih memerlukan pertimbangan kita sendiri.
Uji Kefahaman
Cuba jawab tanpa melihat semula terlebih dahulu.
Aktifkan JavaScript untuk menjawab kuiz interaktif.
Fikir & Jawab
Bina Rumusan Anda
Cuba tulis 2–3 ayat menggunakan perkataan sendiri.
- Bagaimanakah data digunakan untuk melatih model?
- Mengapakah ujian pada contoh baharu diperlukan?
- Apakah batas yang ditunjukkan oleh contoh alas berwarna?
Jika sebuah aplikasi mendakwa dapat mengelaskan semua gambar dengan tepat, apakah dua bukti yang ingin anda lihat sebelum mempercayainya?
Catatan ini tidak dihantar atau disimpan oleh NilamOnline. Salin catatan sendiri sebelum meninggalkan halaman jika mahu menyimpannya.
Maklumat Bacaan
- Tajuk
- Bagaimana AI Mengenali Corak?
- Pengarang
- S. Musa
- Penerbit
- Edura Creative
- Tahun
- 2026
- Bahasa
- Bahasa Melayu
- Jenis
- Artikel Teknologi Digital
Salin secara manual
Anda akan dibawa ke portal rasmi AINS dalam tab baharu. NilamOnline bukan portal rasmi AINS atau KPM.
Sumber bacaan
- What is Machine Learning? ↗ — Google for Developers
- Supervised Learning ↗ — Google for Developers
- Neural networks ↗ — Google for Developers
- Linear regression: Gradient descent ↗ — Google for Developers
- Datasets: Dividing the original dataset ↗ — Google for Developers
- Overfitting ↗ — Google for Developers
- Fairness: Identifying bias ↗ — Google for Developers
- Thresholds and the confusion matrix ↗ — Google for Developers